SOURCE SUMMARY
원문 핵심 요약
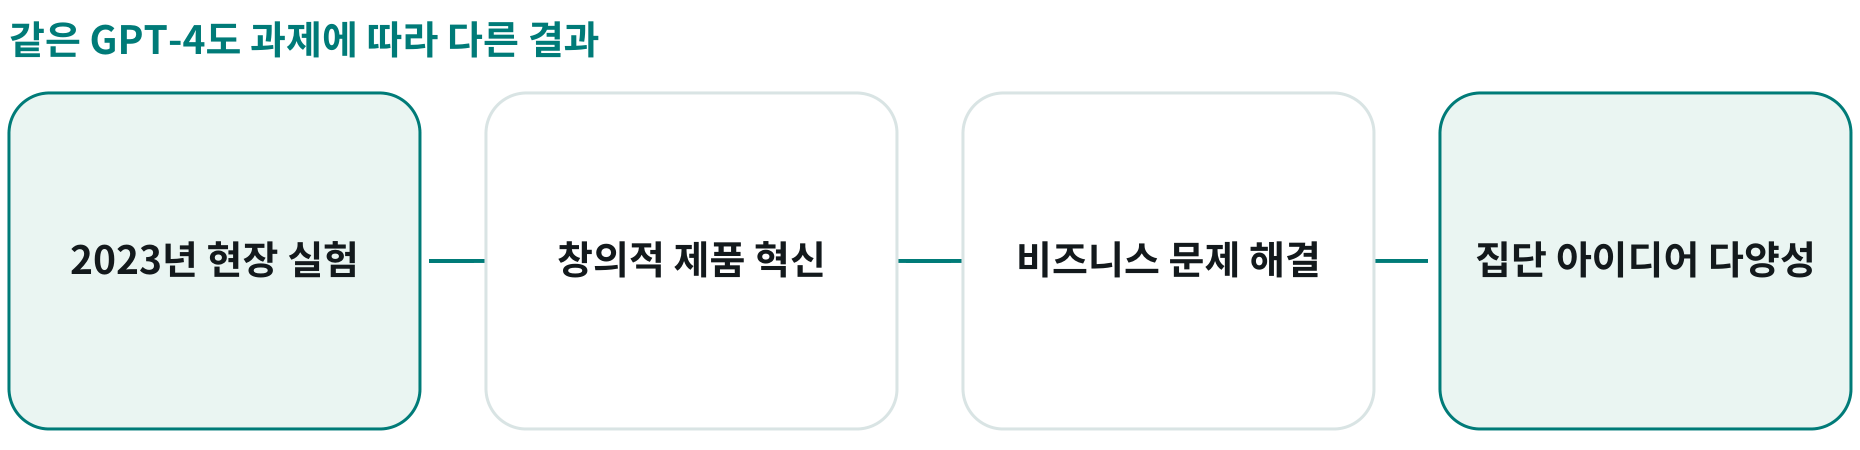
아이디어 확대와 잘못된 문제 해결을 동시에 보여준 현장 실험
잘하는 과제와 위험한 과제를 구분
BCG 컨설턴트 758명을 대상으로 GPT-4 사용 효과를 비교했다.
- 창의적 제품 혁신
- +40%
AI 비사용 집단 대비 과제 성과
- 비즈니스 문제 해결
- −23%
도구 역량 밖의 실험 과제 성과
- 집단 아이디어 다양성
- −41%
AI 비사용 집단 대비 의미적 다양성
특정 2023년 모델·과제·표본의 결과로 현재 모든 AI에 일반화할 수 없다.
원문에서 확인한 핵심
핵심 위험
그럴듯한 답을 믿으면 도구가 못하는 과제에서 가치가 훼손될 수 있다.
다양성 보존
사람의 독립 발상과 AI 보조 발상을 함께 활용할 것을 제안한다.
핵심 논리와 실행 조건
역량 경계
한 번 정하고 끝내지 않기
모델과 과제가 바뀔 때 적합성과 사람의 협업 방식을 반복 검증한다.
운영 변화
교육만으로 충분하지 않다
데이터 기반·실험·역할·업무 흐름을 함께 조정하고 과신을 다룬다.
과제별 검증을 통해 맡길 일과 사람이 판단할 일을 정하는 것이 출발점이다.
APPLICATION PROPOSAL
별도의 적용 제안
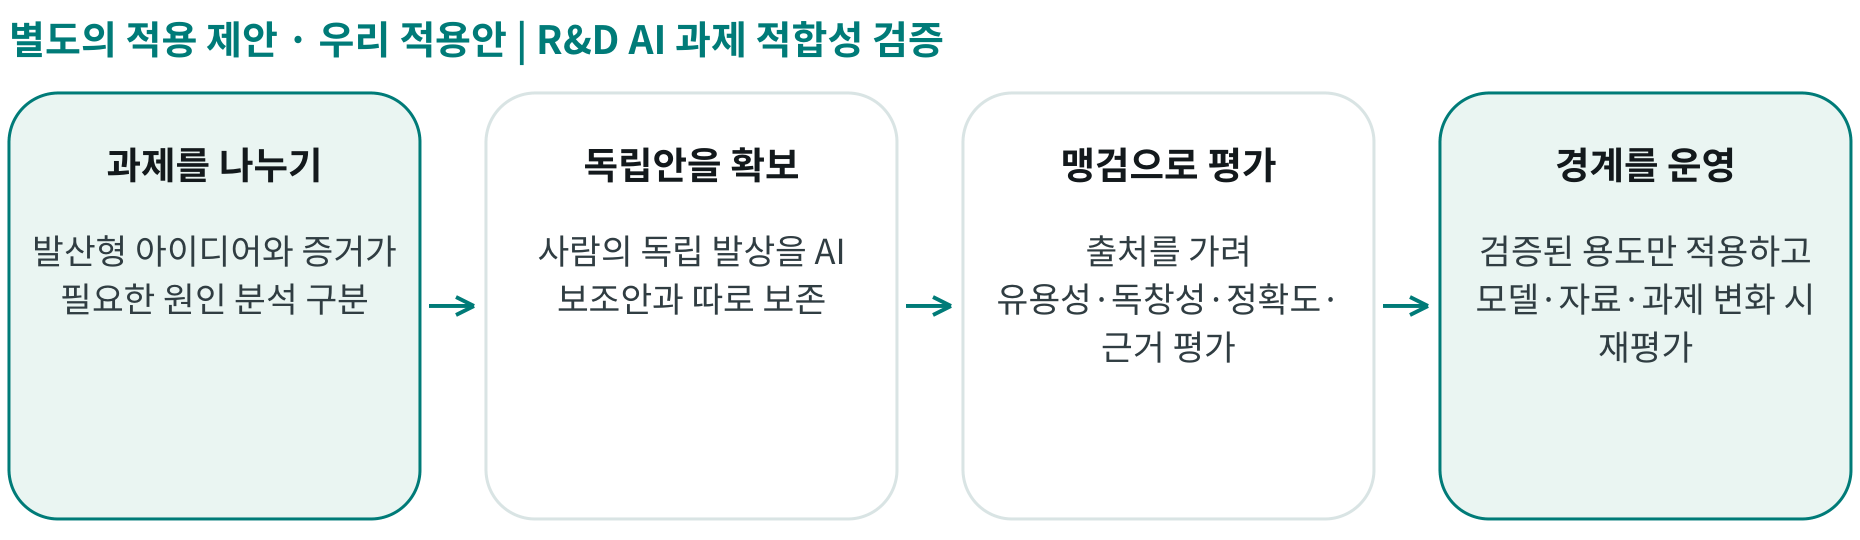
우리 적용안 | R&D AI 과제 적합성 검증
아이디어 발산과 기술 판단에 서로 다른 검증 적용
제품 개선 아이디어와 과거 고장 분석
완료된 과제로 AI 보조·비보조 비교
과제를 나누기
발산형 아이디어와 정답·증거가 필요한 원인 분석을 구분한다.
독립안을 확보
사람이 먼저 낸 아이디어를 보존하고 AI 보조안과 별도로 모은다.
맹검으로 평가
출처를 가린 채 유용성·독창성·정확도·근거 품질을 평가한다.
경계를 운영
검증된 용도만 적용하고 모델·자료·문제 변화 시 재평가한다.
효과를 확인할 지표
기술적 정확도
고장 원인·제약 위반·사실 오류를 정답 사례로 검증한다.
발상 다양성
유사 아이디어 중복률과 독립적인 접근의 수를 확인한다.
검토 포함 효율
초안 생성부터 검증·수정까지의 총시간을 비교한다.
실행 권한과 품질 통제
R&D 책임자
사용 가능한 과제와 금지·재검증 조건을 정한다.
품질·전문가
원인 분석과 안전·규격 관련 판단을 독립 검토한다.
평가 담당
동일 조건·평가 기준과 모델 버전을 기록한다.
- 과제·정답 정의
- 독립·보조안 비교
- 맹검 평가
- 사용 경계 갱신