SOURCE SUMMARY
원문 핵심 요약
관련 부분 요약 · AI 확산 과정의 플랫폼·데이터 유지 비용
실제 업무 패턴으로 구조와 운영 책임을 다시 맞춘다
McKinsey 내부 Lilli 사례와 기업 변혁 경험
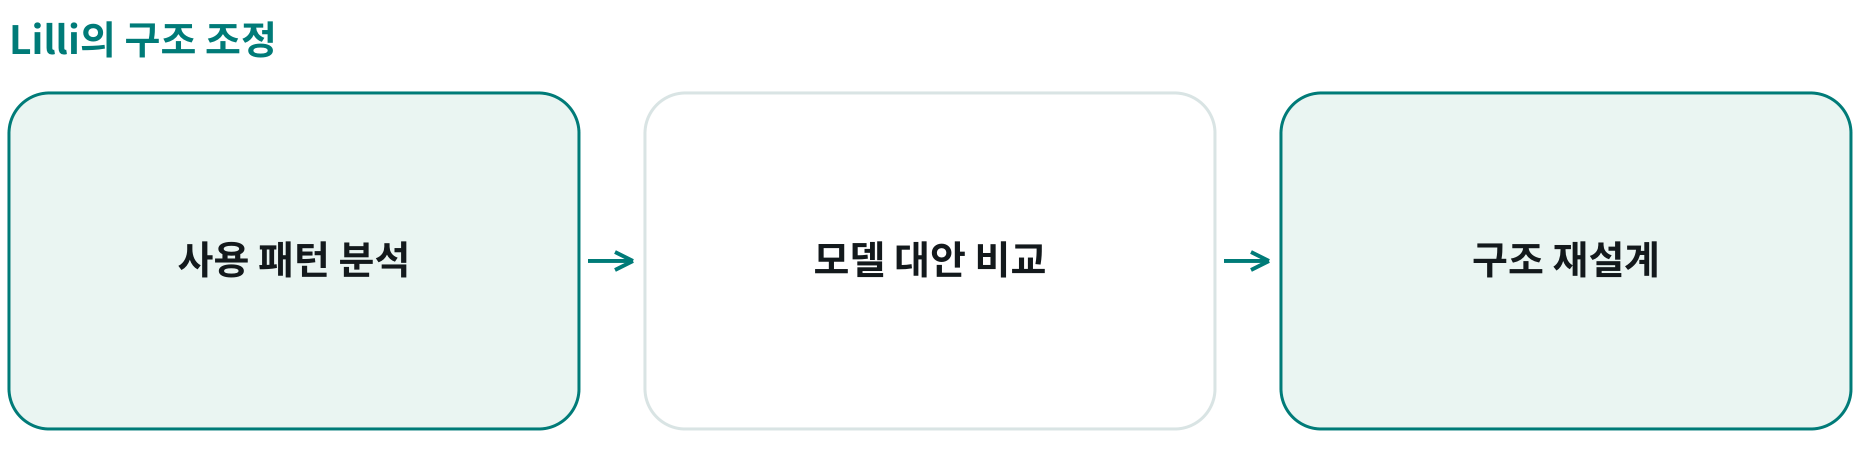
구조 조정
모델별 속도·정확도·비용을 비교해 특정 제공자 의존 구조를 재설계
전체 단위비용
호출·검색·도구·자료 이동·저장과 현장별 재작업을 함께 계산
지속 운영
모델 변화·자료 드리프트에 대한 재검증·배포·유지 역량을 확보
원문에서 확인한 핵심 구조
원문의 실행 포인트
데이터 유지 책임
새 구축에 밀려 기존 데이터 제품이 노후화되지 않도록 비용·책임 배분
재사용 관측
데이터 재사용과 현장 복제의 부담을 확인
원문이 제시하는 실행 원리
기존 시스템과 공존
통합 기반부터 현대화
모듈형 구조로 기존 시스템과 새 AI가 함께 작동하도록 한다.
역할 명세
구축과 운영의 인계
AI 조직·IT·데이터 소유자 사이 지원과 인계 책임을 분명히 한다.
초기 시범의 비용만 보면 확산에 필요한 재작업·운영·데이터 유지·품질 검증을 놓칠 수 있다.
APPLICATION PROPOSAL
별도의 적용 제안
우리의 적용안 PLM AI의 완료 업무당 운영비
토큰 요금 밖의 검색·검토·현장 적응 비용까지 기록
우리의 제안 · 기존 PLM/ERP의 변경 근거 검색 시범
운영 반영 전 읽기 전용·분리 환경으로 검증
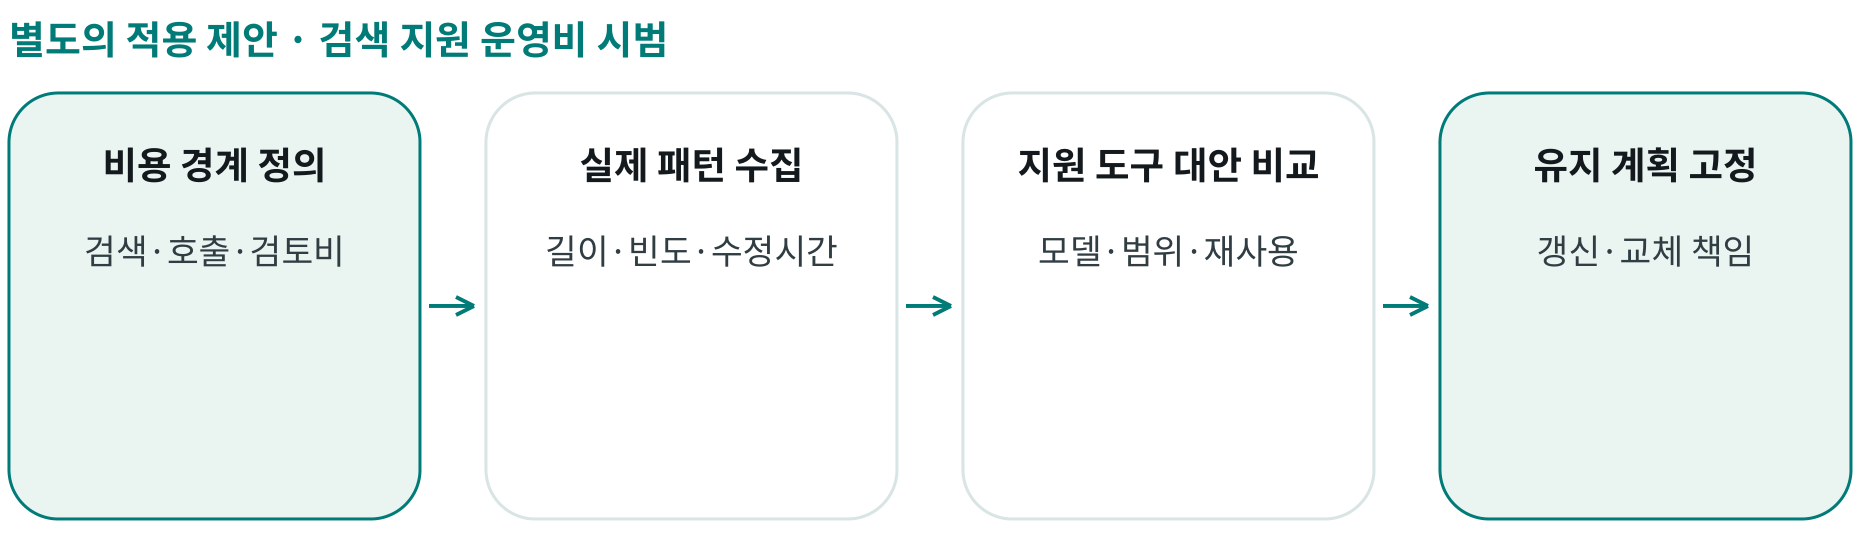
비용 경계 정의
입력·검색·모델 호출·도구·저장·재시도·검토·지원 비용을 구분
실제 패턴 수집
자료 길이·요청 유형·사용 빈도·오류·사람 수정 시간을 관측
지원 도구 대안 비교
기존 시스템을 유지하며 검색 지원 모델·검색 범위·재사용 방식을 시험
유지 계획 고정
문서 갱신·권한 변경·모델 교체·드리프트 점검의 소유자와 비용 지정
기준선과 비교할 검증 지표
완료 업무당 비용
필요한 품질로 검토 완료된 업무 1건의 총 비용
현장 복제 부담
다른 제품군·공장의 스키마·절차·화면을 맞추는 작업량
지속 품질
새 자료·시간 경과·모델 변경 후의 근거 정확도와 오류
적용 전에 고정할 통제
품질 우선
단가만 낮추기 위해 검토·안전·접근 통제를 생략하지 않음
운영 소유권
구축팀과 운영팀의 수정·장애·회귀 검증 책임을 문서화
비용 가정 공개
측정값·예측값·공통 비용 배분 방식을 구분
- 범위·기준선 정의
- 데이터·근거 연결
- 병행 시범·오류 기록
- 사람 승인 후 확대